 HIT专家网

来源:HIT专家网 作者:安志萍
【编者按】
医疗数据挖掘是近年来的行业热词,但真正的落地路径,对医院信息部门的工程师而言,常常“看得见、够不着”:市面常见的工具与模型,多面向专业数据科学家,离工程师的日常场景仍有距离,并不容易直接上手。
本文是“唤醒数据系列”的开篇。作者结合自身实践,系统梳理了适用于医院信息部门的数据挖掘与分析的方法与经验。本系列文章以公开数据集作为挖掘对象,先把方法论跑通、跑明白,有助于后续迁移到院内真实数据的实战场景。
在后续篇章中,作者将依据本文提出的四大方法范式,分享具体场景落地实践。敬请读者朋友关注。
绝大多数医疗机构的数据仍处于“沉睡状态”。以三甲医院为例,每年产生的住院记录、检验结果、影像报告等约数百万条,这些数据散落在不同系统中,很少被系统性地分析、挖掘并反哺临床。
数据挖掘(Data Mining)正是唤醒这些数据价值的核心技术。它并非简单的统计汇总,而是通过机器学习、模式识别、关联分析等方法,从海量数据中发现隐藏的、有价值的、可解释的知识。在医疗领域,数据挖掘的目标不是替代医生的临床判断,而是为决策提供证据增强(Evidence Augmentation),让经验有据可依,让直觉有数可查,降低漏诊概率。正如中医所言“上医治未病”,数据挖掘的本质,正是通过历史数据的规律发现,实现对未来的预判与干预。
医疗数据挖掘遵循经典的CRISP-DM(跨行业数据挖掘标准流程):业务理解(Business Understanding)→ 数据理解(Data Understanding)→ 数据准备(Data Preparation)→ 建模(Modeling)→ 评估(Evaluation)→ 部署(Deployment)。但在医疗场景中,每一步又都有其特殊性。
基于当前政策导向与临床现实,本系列文章将以公开医疗健康数据集为研究对象,提出面向临床价值的数据挖掘思路,侧重理论分析路径的系统梳理,旨在为医院信息部门同行提供一种可迁移、可借鉴的方法。
数据集实战:从数据到洞察的完整链路
本研究分析数据来源于Kaggle,数据收集自印度旁遮普省卢迪亚纳的戴亚南德医学院和医院(Dayanand Medical College and Hospital)的心脏病研究所,涵盖从2017年4月1日至2019年3月31日期间的患者入院情况。该数据集共15757条记录、56个特征值。每一条记录代表了1次入院记录,涉及12244名患者,其中2598名患者有多次入院记录。
技术工具采用Python 3.7 + PyCharm 2022.2(Community Edition)。
首先,分析该数据集,其结构总体可概括为“一核心三维度”:
核心标识:患者ID(MRD No.)、住院流水号(SNO),支持跨次就诊的纵向追踪;
人口学维度:年龄(AGE)、性别(GENDER)、城乡来源(RURAL),构成患者基线画像;
临床维度:合并症(高血压HTN、糖尿病DM、冠心病CAD、心衰HEART FAILURE、房颤AF、瓣膜病VALVULAR等20余种二元分类诊断)、实验室指标(血红蛋白HB、白细胞TLC、血小板PLATELETS、血糖GLUCOSE、尿素UREA、肌酐CREATININE、BNP、射血分数EF等连续变量)、入院方式(急诊/门诊TYPE OF ADMISSION-EMERGENCY/OPD,以及衍生字段ADMISSION_TYPE);
结局维度:住院时长(DURATION OF STAY)、ICU停留时间(Duration of intensive unit stay)、出院结局(OUTCOME,如好转/死亡)、出院后再入院记录(可通过MRD No.实现跨次追踪)。
这类数据集的挖掘价值在于:它同时具备横截面的“快照能力”和纵向的“追踪能力”。前者支持单次住院的深入分析,后者支持跨次就诊的时序性演进研究。
三维需求:管理、临床与运营的差异化视角
同一套数据,在不同用户视角下会折射出不同的价值。
管理视角:主要关注的是“效率与风险”。例如:哪些患者占用床位时间最长?哪些患者出院后短期内会回来?不同合并症组合的资源消耗差异如何?这些问题的答案直接影响床位调配、绩效考核和质控指标优化。
临床视角:主要关注的是“规律与路径”。例如:糖尿病合并心衰的患者,其肾功能恶化轨迹有何特征?哪些实验室指标的动态变化最能预测不良结果?哪些治疗对特定亚群更有效?这些问题的答案可以转化为临床路径优化方案。
运营视角:主要关注的是“效能与成本”。例如:能否将患者自动分类为“需密集随访”“常规随访”与“自我管理”?不同亚群患者的再入院驱动因素是否不同?关联规则能否发现“某合并症→再入院”的隐藏模式?这些问题的答案最终支撑精准随访体系的搭建,并服务于患者全生命周期管理中的效能提升与成本优化。
综上可知,数据挖掘的核心价值,就在于用同一套数据底座,通过不同的分析视角和方法组合,能够同时满足不同角色的各类需求。
可挖掘场景:四大方法范式下的分析路径
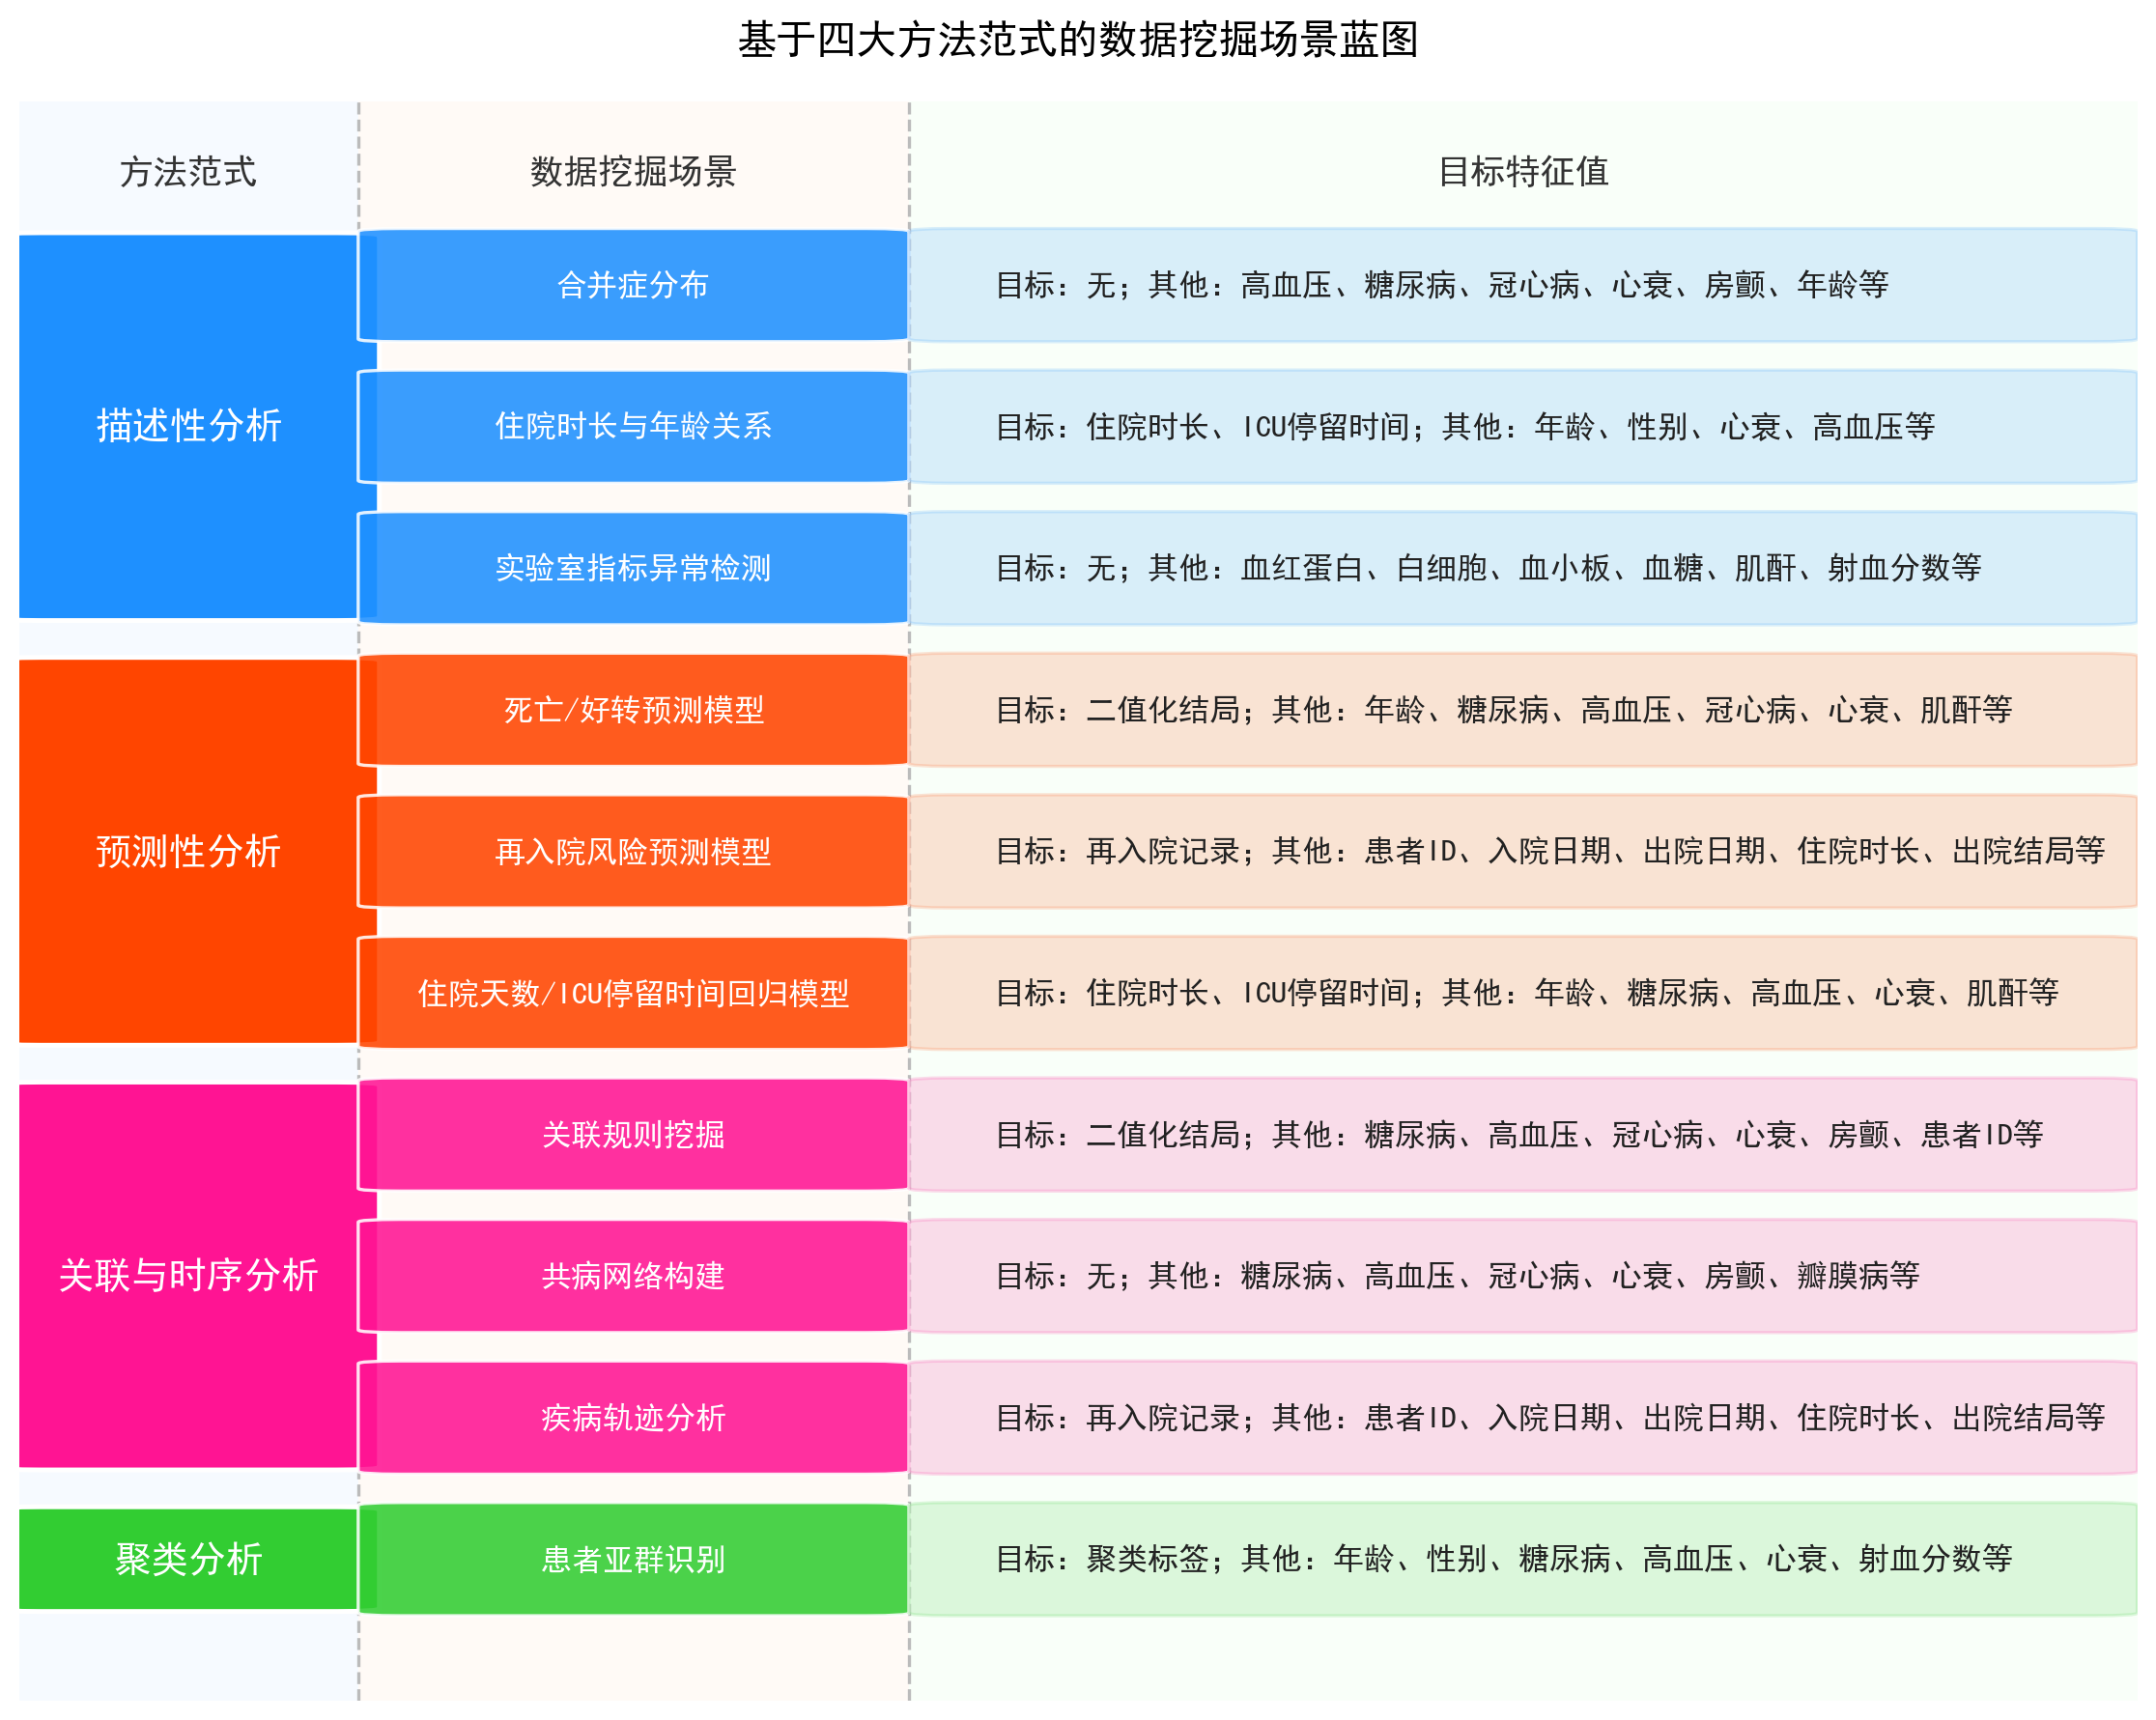
根据数据挖掘常用四大方法范式与本数据集的特征结构形成对应关系,共同构成“从数据到思考到分析”的完整链路,为后续各场景技术路线的展开提供方法框架。
图1所示为基于四大方法范式的数据挖掘场景蓝图,后续列举部分为笔者已研究内容。
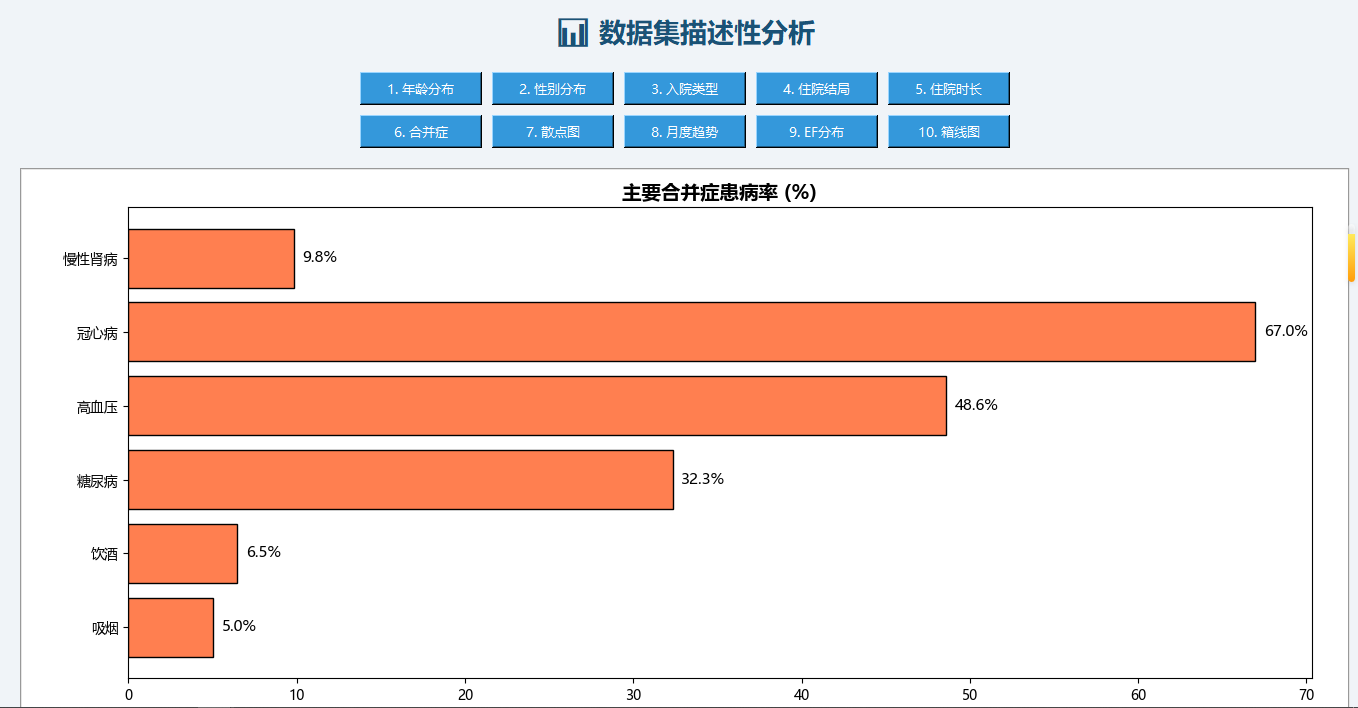
1.描述性分析:围绕数据集中的现状与分布展开。例如:数值特征分布或集中趋势,合并症分布与人口学构成,住院时长与ICU停留时间的资源消耗统计,实验室指标的分布与异常值筛查,不同入院方式与结局的交叉描述等。图2所示为主要合并症患病率分析图。
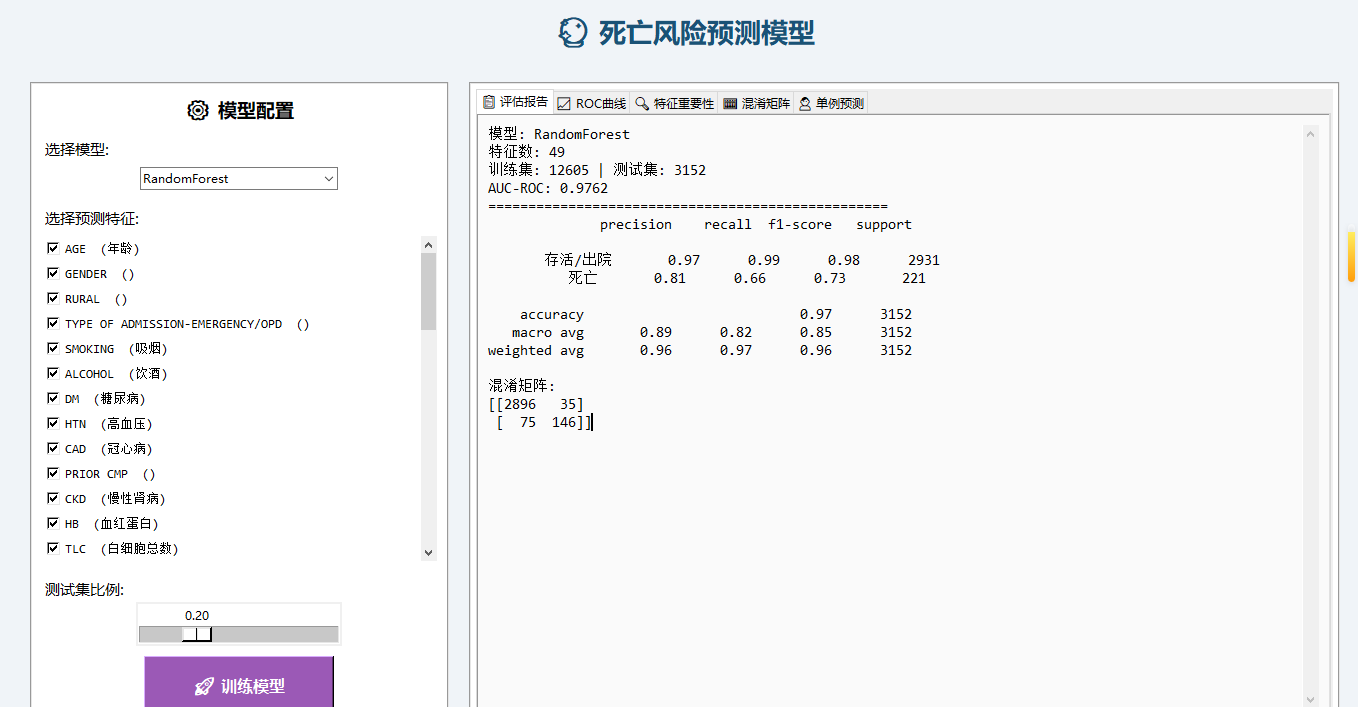
2.预测性分析:围绕结局与风险展开。例如:构建死亡/好转预测模型,构建 跨次追踪再入院风险预测模型,以住院时长或ICU停留时间为连续目标构建回归模型等。
图3 所示为死亡风险预测模型主界面图,涵盖模型性能评估、特征重要性、混淆矩阵与单病例预测核心功能。
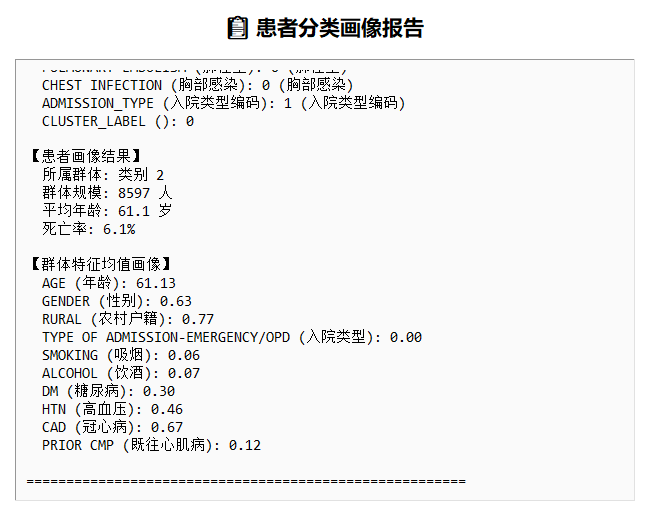
3.聚类分析:围绕患者分型与亚群识别展开。例如:基于人口学、合并症与实验室指标进行无监督聚类,将患者自动归类为“需密集随访”“常规随访”与“自我管理”,支撑精准随访体系搭建。
图4所示为单病例患者画像报告,依托分类分型,可高效开展差异化针对性管理。
4.关联与时序分析:围绕事件之间的关联与演进路径展开。例如:通过关联规则挖掘“某合并症组合→再入院”“某实验室指标异常+某合并症→不良结局”的内在关联等。
图5所示为患者疾病轨迹分析主界面,针对多次住院患者构建完整的疾病演进链条,从而预判下一步高风险事件的发生概率。
结语
综上分析,再入院预测可提前评估风险,患者画像可对比差异,疾病轨迹分析可预判疾病未来进展风险等。它们共同指向一个核心认知:数据挖掘不是技术堆叠,而是对临床逻辑的数字化重构。
更进一步看,医疗数据挖掘的价值,不仅在于把数据变成可分析的对象,更在于把隐性的临床经验转化为可验证、可迭代的知识体系。它让诊疗决策从“凭经验”走向“可追溯”,让风险管理前移到“可事前预警”,让医疗质量的提升真正走向“可持续优化”。
因此,当下也迫切呼吁医疗机构的从业者都应当建立起“数据思维”,即临床人员需要理解数据的边界与可达性,数据分析人员需要尊重临床的语境与复杂性。当双方能够在同一套逻辑下顺畅对话时,数据才能真正从“沉睡的资产”转化为支撑临床的“觉醒的生产力”。
【作者简介】
安志萍,高级工程师,在职博士学历,专业技术上校退役。CHIMA委员,中国研究型医院学会医疗信息化分会理事,中国医疗保健国际交流促进会医学工程与信息学分会委员,中国医学装备协会医院物联网分会常务委员,《中国数字医学》杂志审稿专家。长期从事医院信息化建设工作。作者观点纯属与同行做技术交流,欢迎批评指正。

精彩不容错过!
我们将尽快与您联系!
【责任编辑:陈曦 版式:蒙辉】

评论前必须登录!
注册