 HIT专家网

来源:HIT专家网 作者:安志萍
【编者按】
在“唤醒数据系列”稿件中,作者安志萍结合自身实践,系统梳理了适用于医院信息部门的数据挖掘与分析的方法与经验。本系列文章以公开数据集作为挖掘对象,采用四大方法范式,分享具体场景的数据挖掘落地实践。
描述性分析(Descriptive Analysis)是数据挖掘流程的首要环节,也是推断性分析与预测建模的基础。其核心在于通过对数据集各变量的统计汇总、分布刻画与交叉组合展示,系统呈现出数据集的基本形态、结构特征与潜在异质性,为后续假设检验、变量筛选和模型构建提供依据。
本文以心血管住院患者数据集为实证材料(数据集来源于Kaggle,数据收集自印度旁遮普省卢迪亚纳的戴亚南德医学院和医院的心脏病研究所,涵盖从2017年4月1日至2019年3月31日期间的患者入院情况。详见《唤醒数据 | 医院信息部门数据挖掘的实战路径》),从单特征、双特征与多特征三个维度选取典型图谱进行展示,并解析其在临床场景中的应用意义。
需要说明的是,本文基于特定数据集进行分析,数据源于单一机构的特定时段,样本具有区域与时间特异性,据此得出的分析结论可能存在偏差。本文重点在于演示分析方法而非论证结论,相关表述仅代表个人观点,不当之处恳请同行批评指正。
一、单特征描述性分析:群体基线的刻画
单变量分析是数据探索的基石。在构建各类模型之前,必须对数据集中的各个独立特征进行逐一理解。通过对核心变量进行分析,旨在构建研究对象的精准基线画像,为后续深层次的关联探索奠定数据认知基础。
1.集中趋势与离散测度
年龄是心血管疾病最重要的不可干预危险因素之一,其分布形态直接影响研究人群的定位与后续分层策略。明确年龄的集中趋势与离散程度,可判断该队列是否以老年患者为主体,或是呈现多年龄段混合特征。
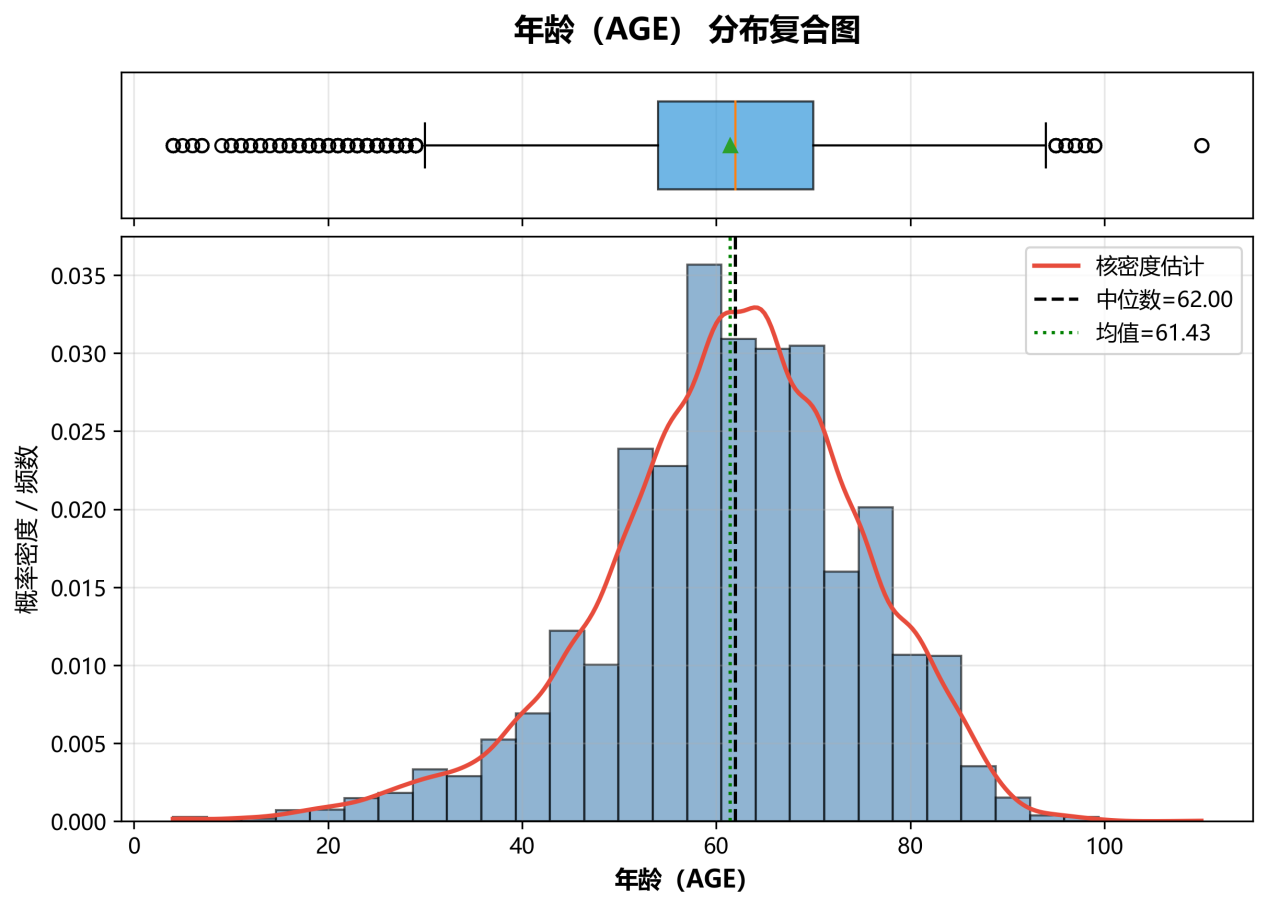
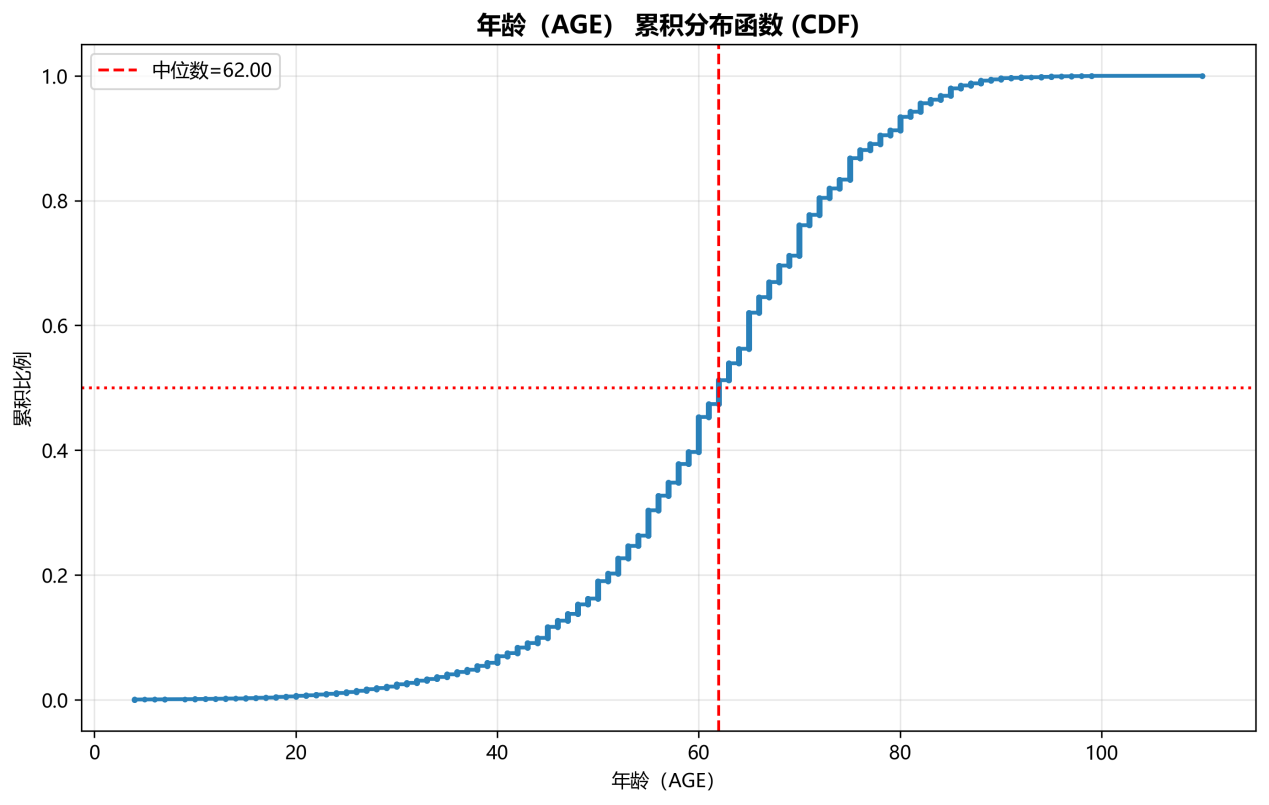
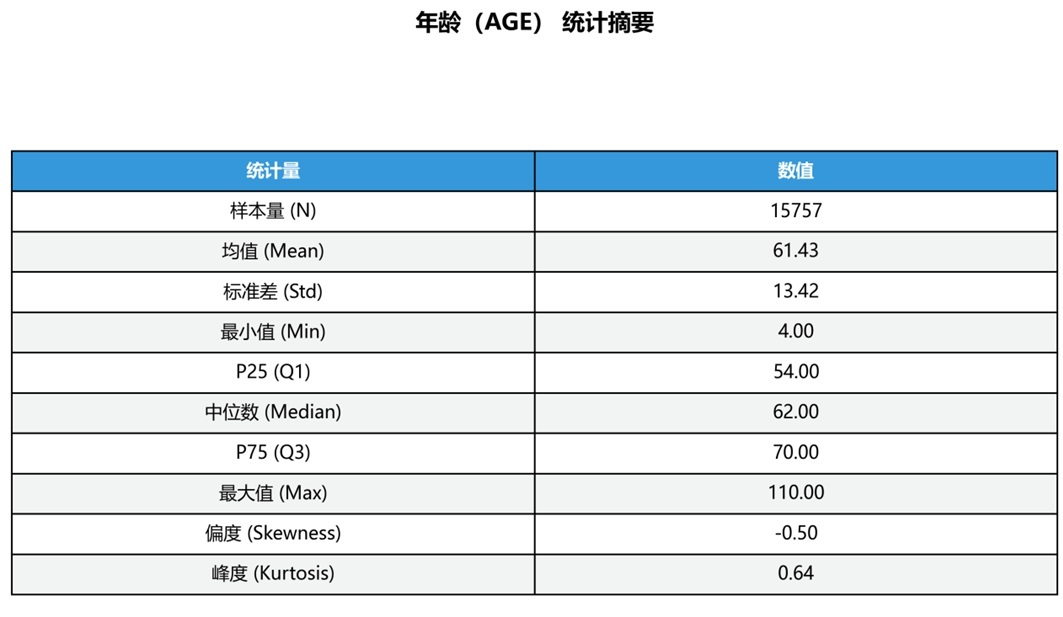
图1显示,该队列的年龄分布主体集中于50-80岁,均值61.43岁、中位数62.00岁,均值与中位数接近;箱线图与核密度曲线显示分布略呈左偏(偏度-0.50,峰度0.64),提示年龄分布相对集中且存在一定低龄尾部。图2的CDF曲线在60岁附近快速上升。结合图3统计摘要表可知P25=54.00、P75=70.00,四分位距为16岁,最大值110岁。
综上结果提示,该队列以中老年患者为主体,存在少量极端高龄值。后续分析建议按年龄段分层,并重点关注高龄人群的医疗资源配置。
2.分布形态与正态检验
临床数据(如住院时长、生化指标)常呈偏态分布。判断数据是否服从正态分布,是决定后续统计分析采用参数检验(如 t 检验)还是非参数检验(如秩和检验)的前提。
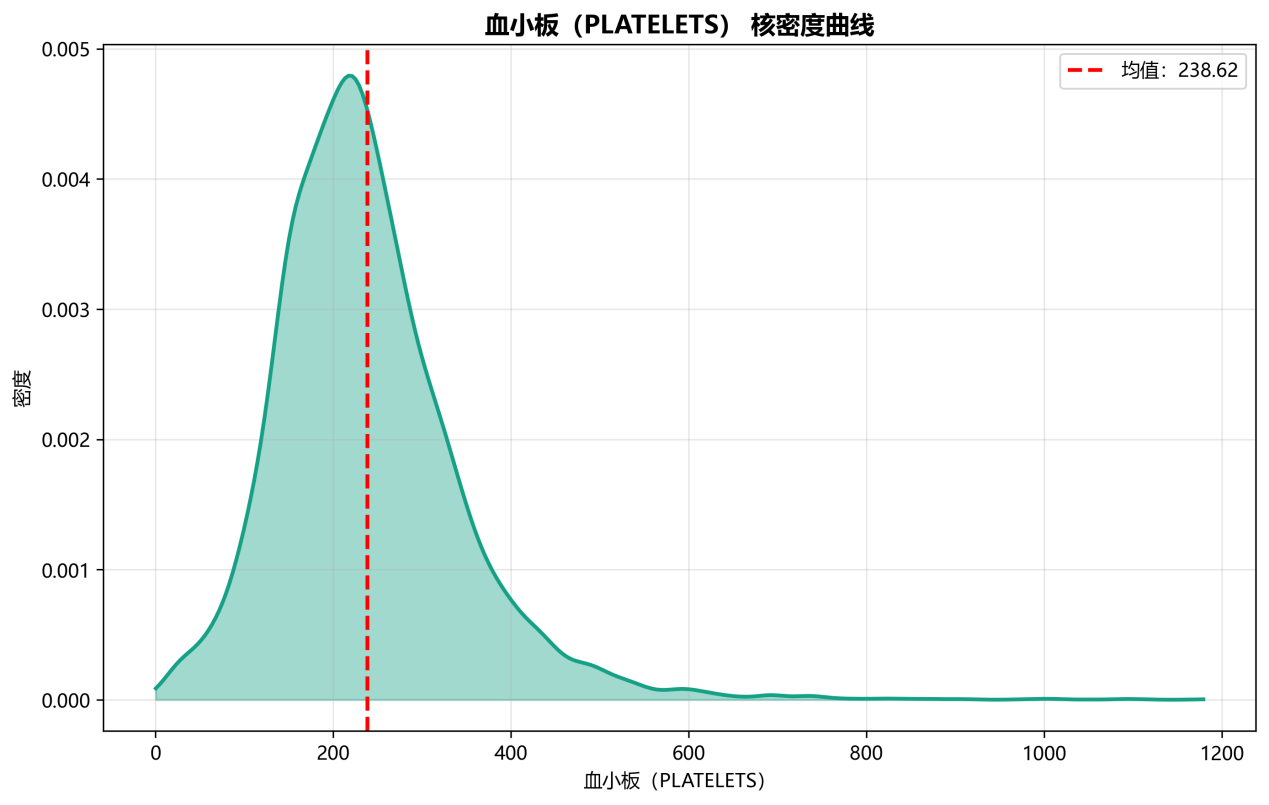
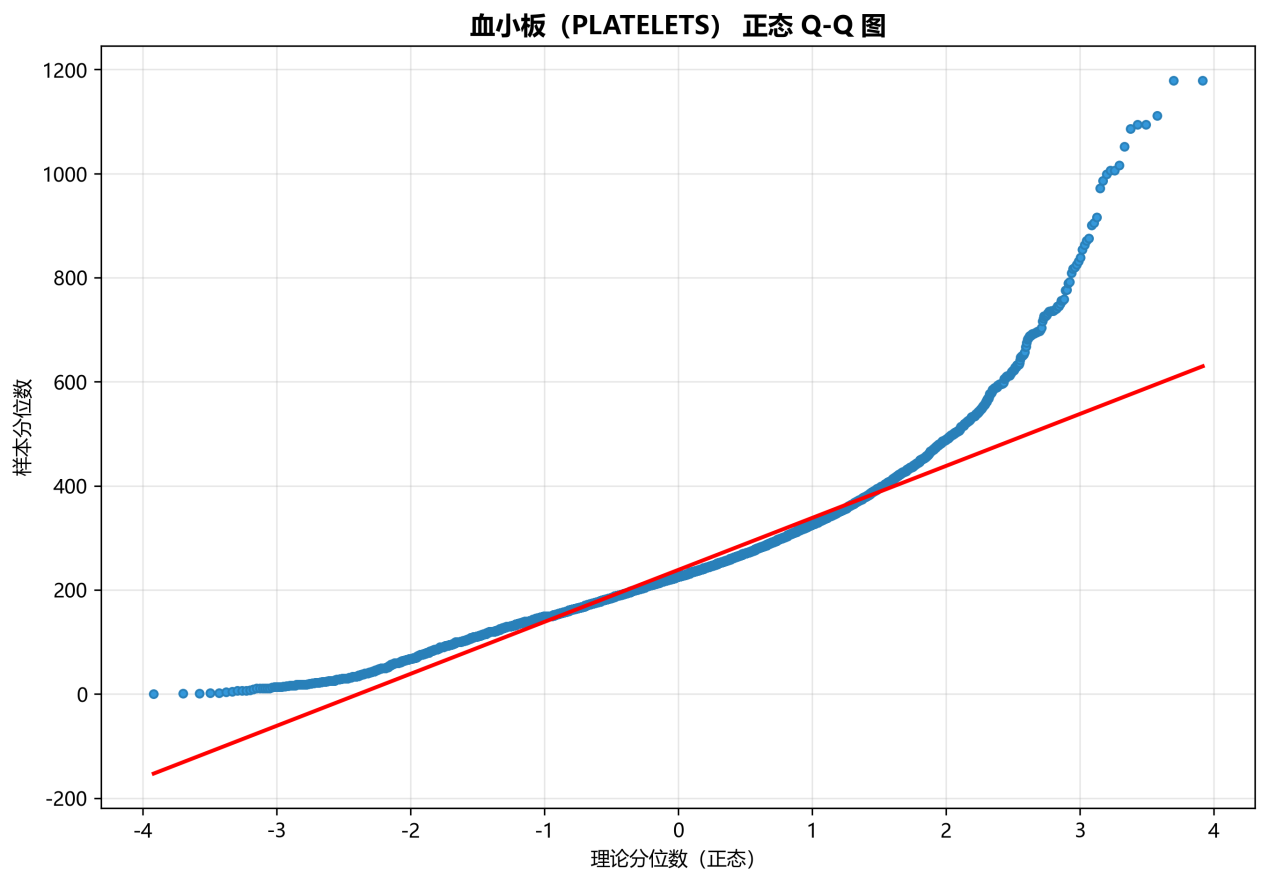
结合图4血小板核密度曲线与图5 Q-Q图可见,数据点在中部接近参考线,但两端明显偏离对角线并呈弯曲状(右端上翘)。这提示血小板分布存在明显的厚尾(Fat Tail)与右偏特征,不满足正态分布的前提假设。因此,为避免极端值扭曲均值,后续针对该指标的组间差异比较,不宜采用常规的参数检验(如 t 检验),而宜采用非参数检验(如秩和检验),以确保统计推断的可靠性。
3.时序演变与季节规律
心血管疾病的发病具有显著的季节性规律,识别入院高峰月份,可为医院床位调度、值班安排与应急预案制定等提供量化依据。
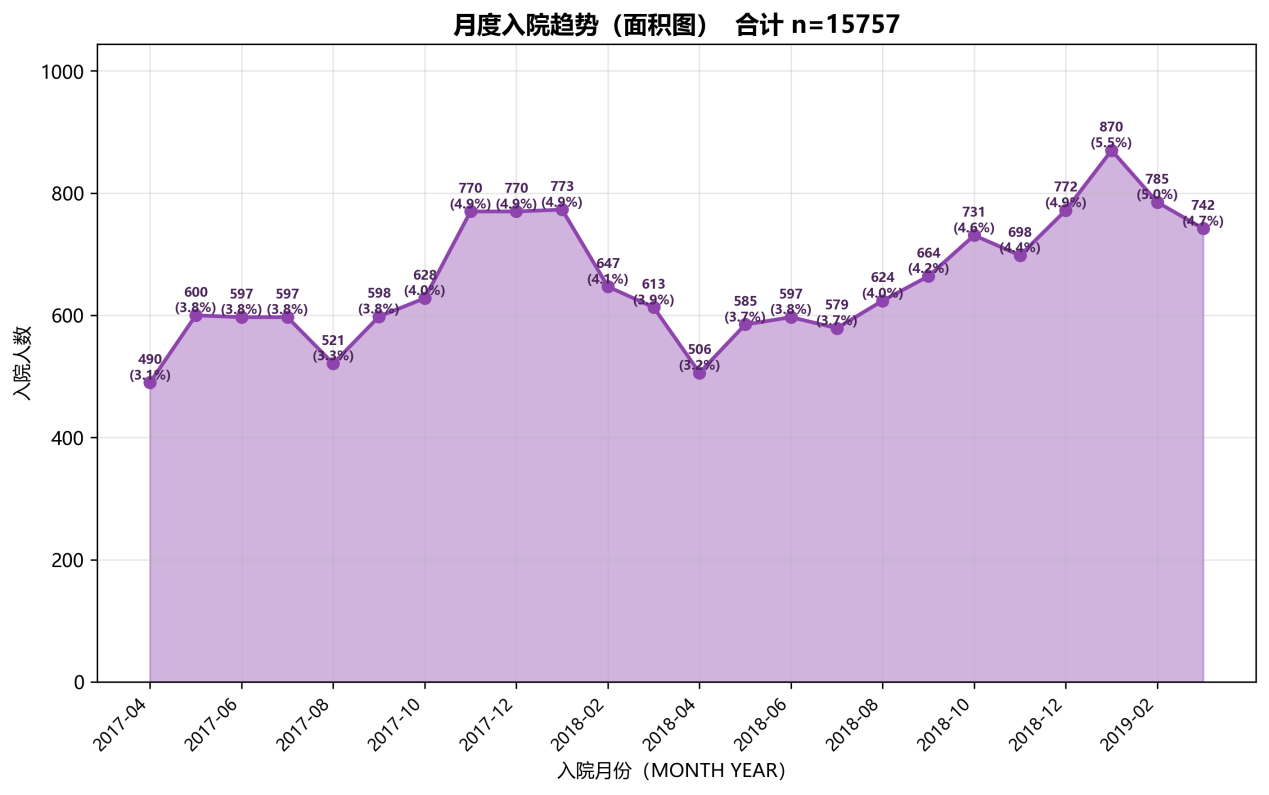
图6显示,该队列心血管疾病患者的月度入院量存在明显波动,呈现出季节性规律。2019年1月出现峰值870例(5.5%),冬春季多个月份处于较高位,夏季相对平稳。建议在峰值月份应提前配置医疗资源,并可进一步结合流感季、气候与节假日效应进行分层验证。
4.疾病负担与“关键少数”
合并症是影响心血管疾病患者预后的关键因素。明确合并症的患病率排序,可判断该队列的疾病谱特征,为专科会诊与设备储备提供依据。
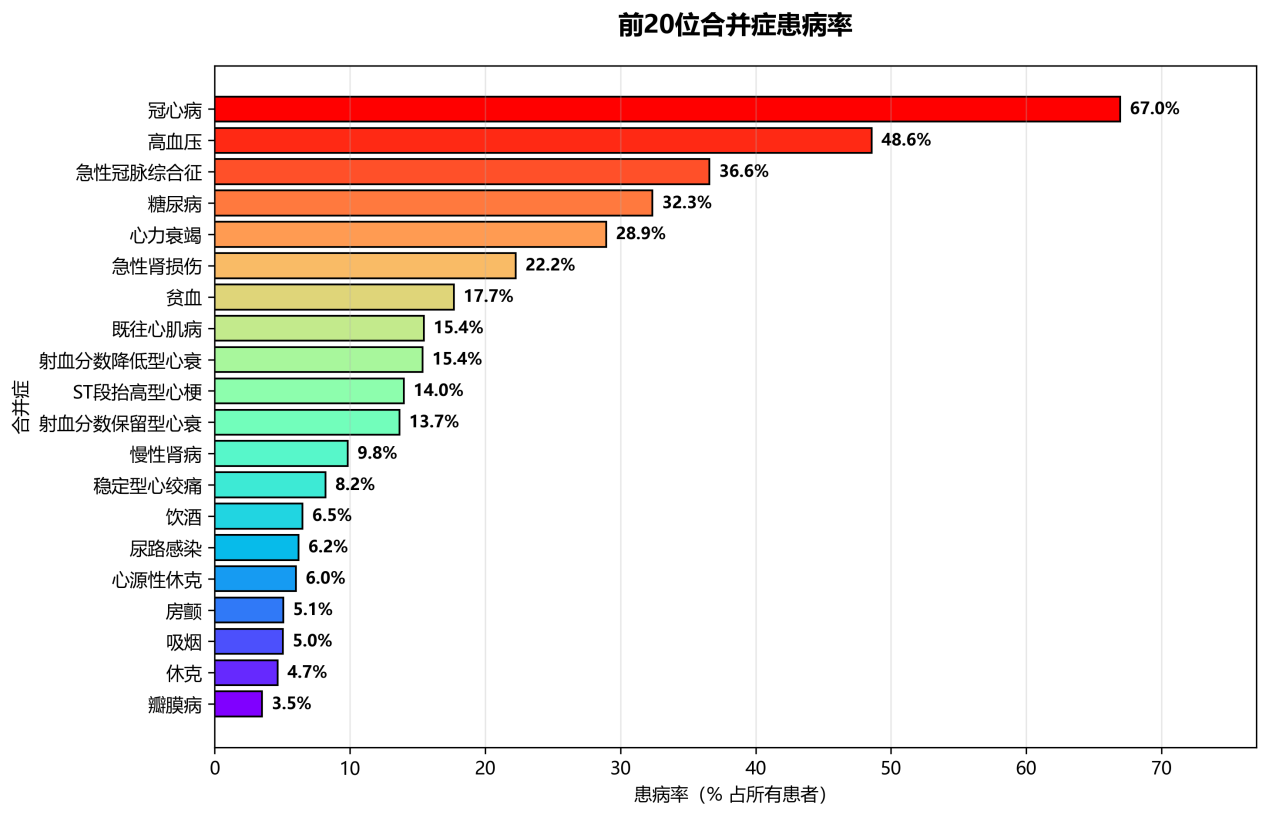
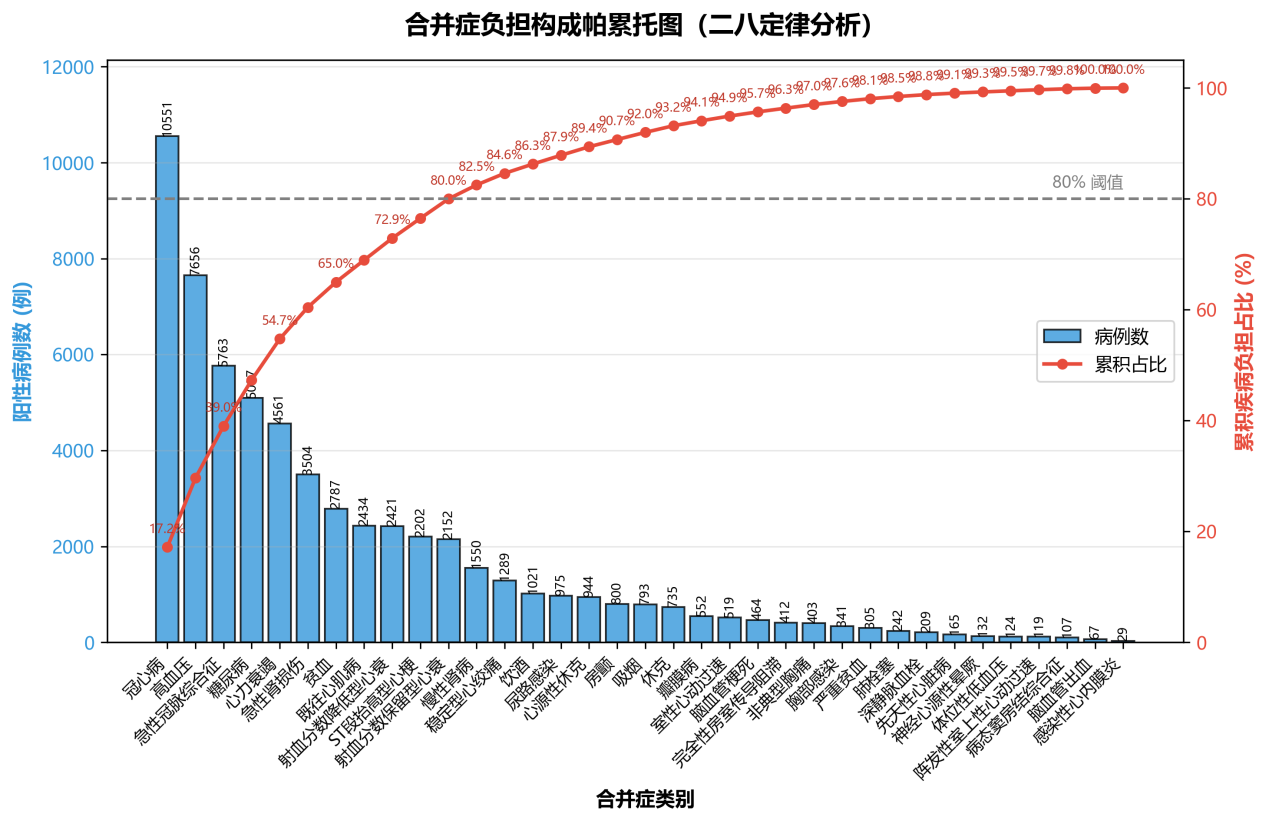
图7显示,在排名前20位的合并症中,冠心病占67.0%、高血压占48.6%、急性冠脉综合征占36.6%、糖尿病占32.3%、心力衰竭占28.9%,其后依次为急性肾损伤、贫血、既往心肌梗死等。图8帕累托图显示,前若干类合并症累计贡献接近80%的病例负担,符合“二八定律”。该队列以“心血管-代谢共病”为主要特征,临床可据此提前配置核心医疗资源,且需警惕急性肾损伤等重症合并症。
5.共病关联与内部结构
合并症之间通常存在复杂的共现与互斥关系。揭示共病关联网络,可为构建合并症指数、制定共病管理路径提供数据支撑。
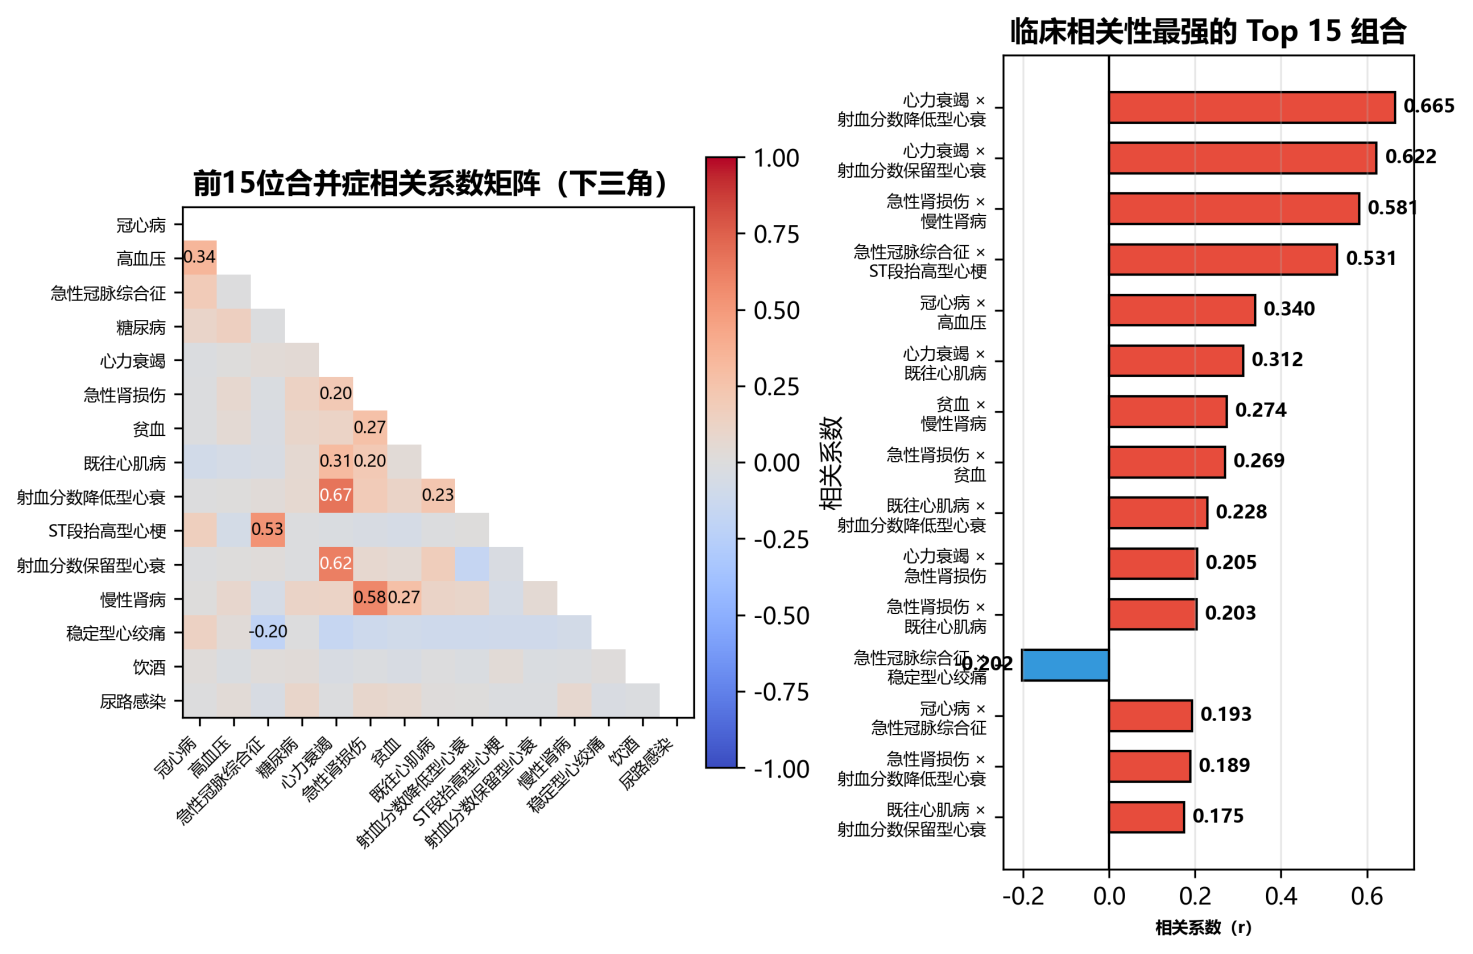
图9显示,合并症之间存在显著的同一疾病谱系的聚集特征。右侧Top15条形图表明,相关性最强的是心力衰竭与其两个亚型(射血分数降低型、保留型,r 分别为0.665和0.622),其次是心肾共病(急性肾损伤与慢性肾病,r=0.581)以及冠心病分类(急性冠脉综合征与ST段抬高型心梗,r=0.531)。
此外,图中唯一显著的负相关为“急性冠脉综合征与稳定型心绞痛”(r=-0.202,蓝色条),提示这两种冠心病表型(Phenotype)在临床诊断中存在互斥或替代升级关系。左侧热力图直观印证了上述关联强度。
二、双特征描述性分析:关联模式的探索
明确了单变量特征之后,临床研究往往更关注变量间的协同变化与相互影响。通过对双变量进行交互分析,量化其共变或互斥模式,可初步判断潜在的因果假设与临床风险。
1.连续变量的线性与单调关联
探讨两个连续型指标(如射血分数EF与脑钠肽BNP)之间是否存在线性或单调关联。
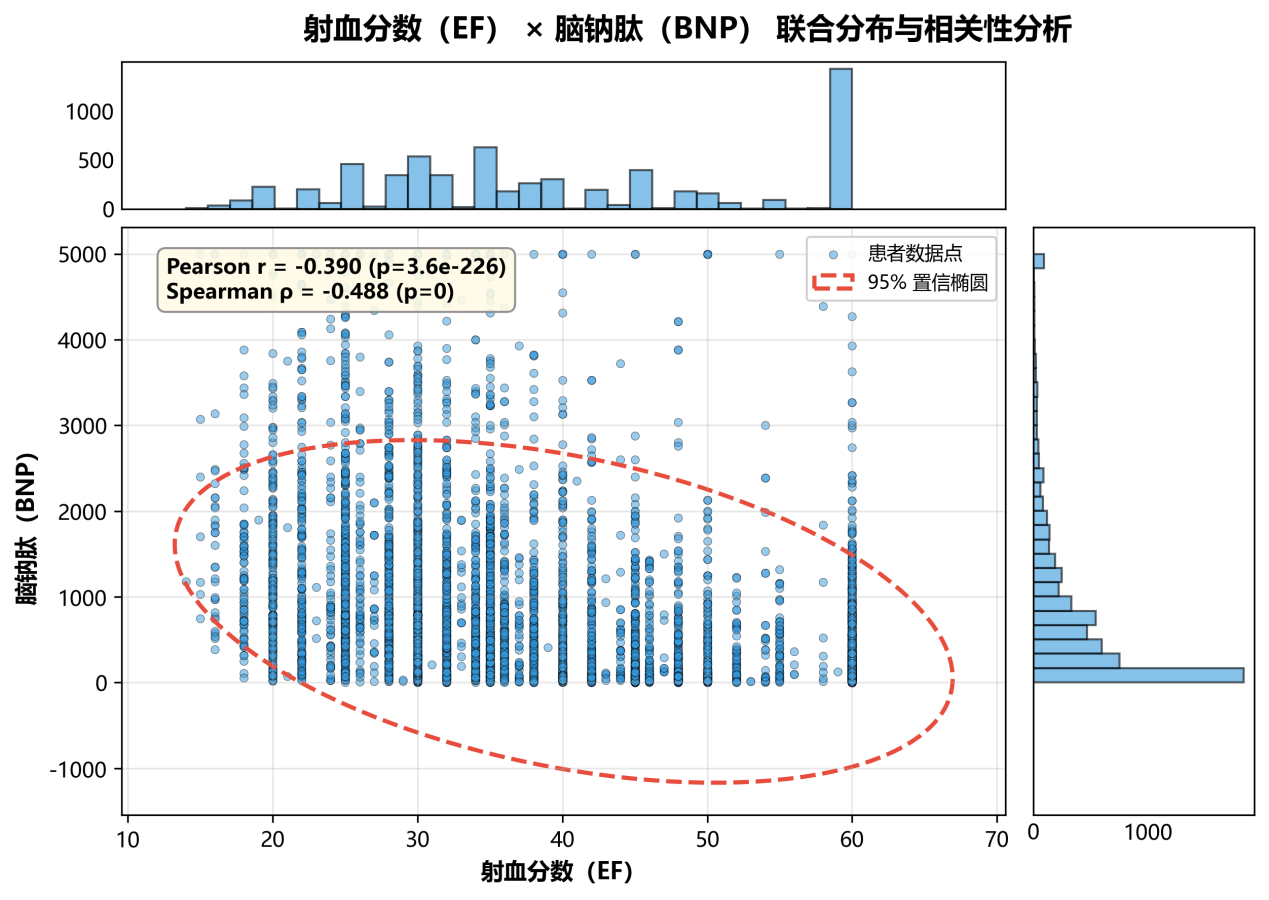
图10显示,射血分数与脑钠肽呈负相关,Pearson线性相关系数r=-0.390(p=3.6e-226),Spearman等级相关系数ρ=-0.488(p=0),提示射血分数越低,脑钠肽水平越高。其中,|ρ|>|r|表明二者的单调关联强度高于线性关联,反映出射血分数下降对脑钠肽升高的影响呈非线性特征。鉴于脑钠肽呈典型的右偏分布(存在高值长尾),Pearson 相关性极易受极端值干扰,而Spearman基于秩次的非参数相关性分析具有更强的鲁棒性,因此其结果更具参考价值。图中95%置信椭圆囊括了主流人群,椭圆外的散点可视为极端重症或异常值,应结合临床进行核查。
2.混合变量的组间分布探查
了解分类变量(如出院结局)在连续指标(如住院时长)上的真实分布差异。
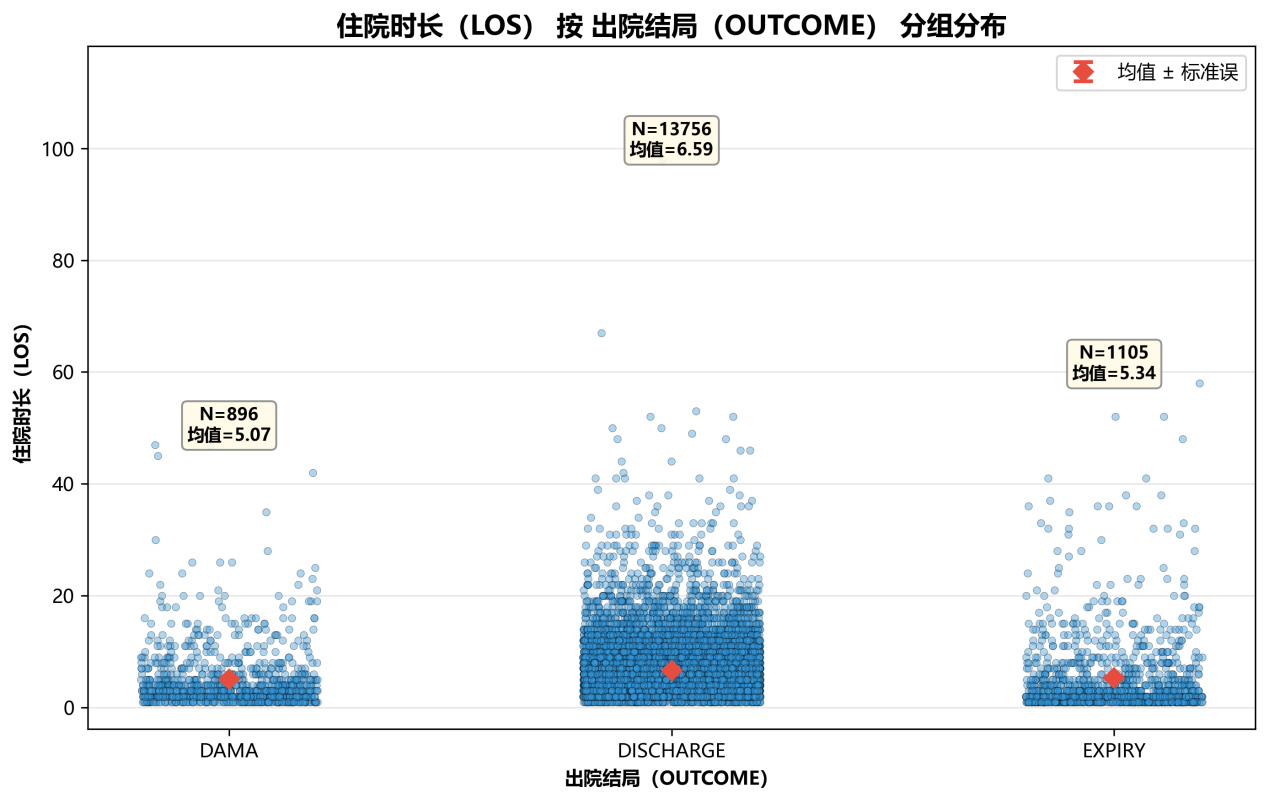
图11显示,患者自动出院(DAMA)组(n=896)均值5.07,正常出院(DISCHARGE)组(n=13756)均值6.59,死亡(EXPIRY)组(n=1105)均值5.34。各组分布均呈右偏,且存在较长住院时长离群点。死亡组均值并非最高,但结合散点分布可见,后续应结合中位数、四分位距及生存分析进一步比较。
3.分类变量的构成差异对比
探讨两个分类变量(如城乡来源与出院结局)之间是否存在构成差异或关联模式。
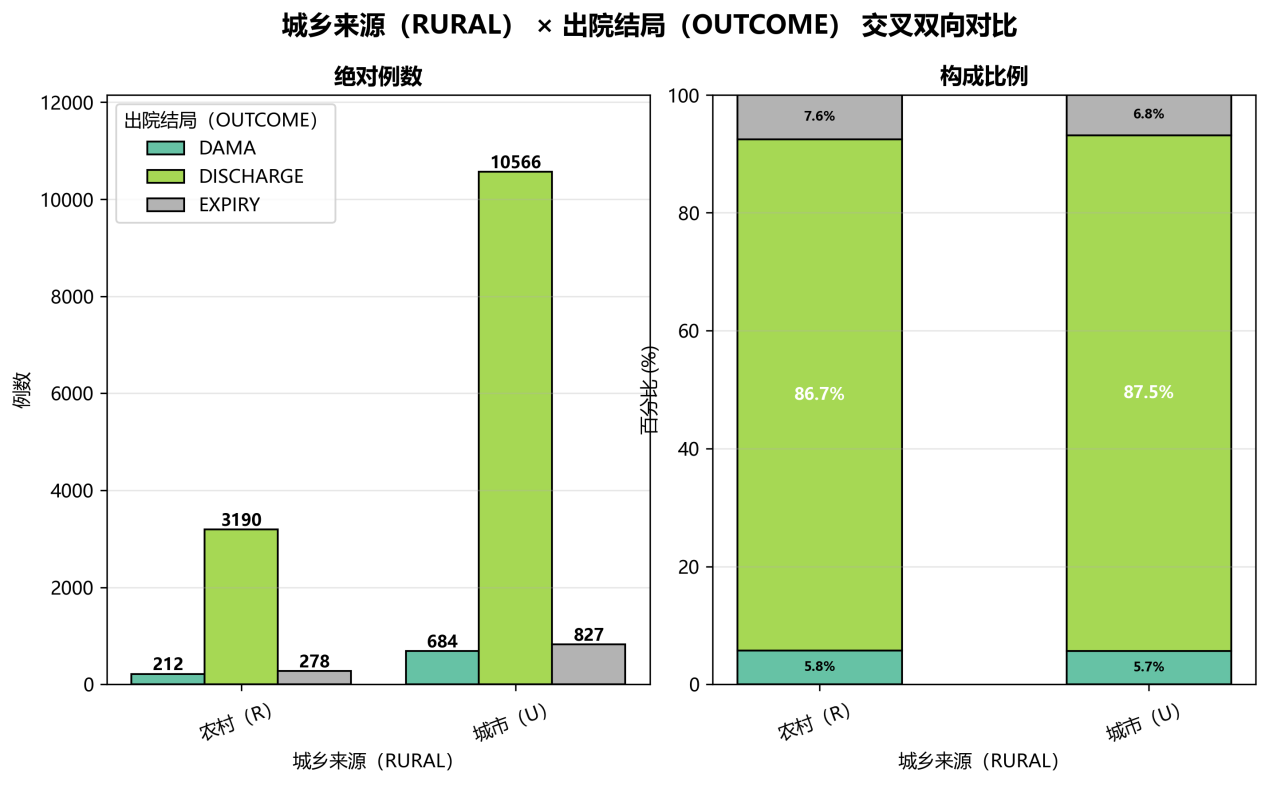
图12显示,构成比例上,农村组死亡(EXPIRY)占7.6%,城市组占6.8%,农村组死亡构成略高;两组DAMA构成占比接近。提示城乡来源与出院结局可能存在构成差异,但需结合年龄、病情及入院方式等因素进行多因素分析。
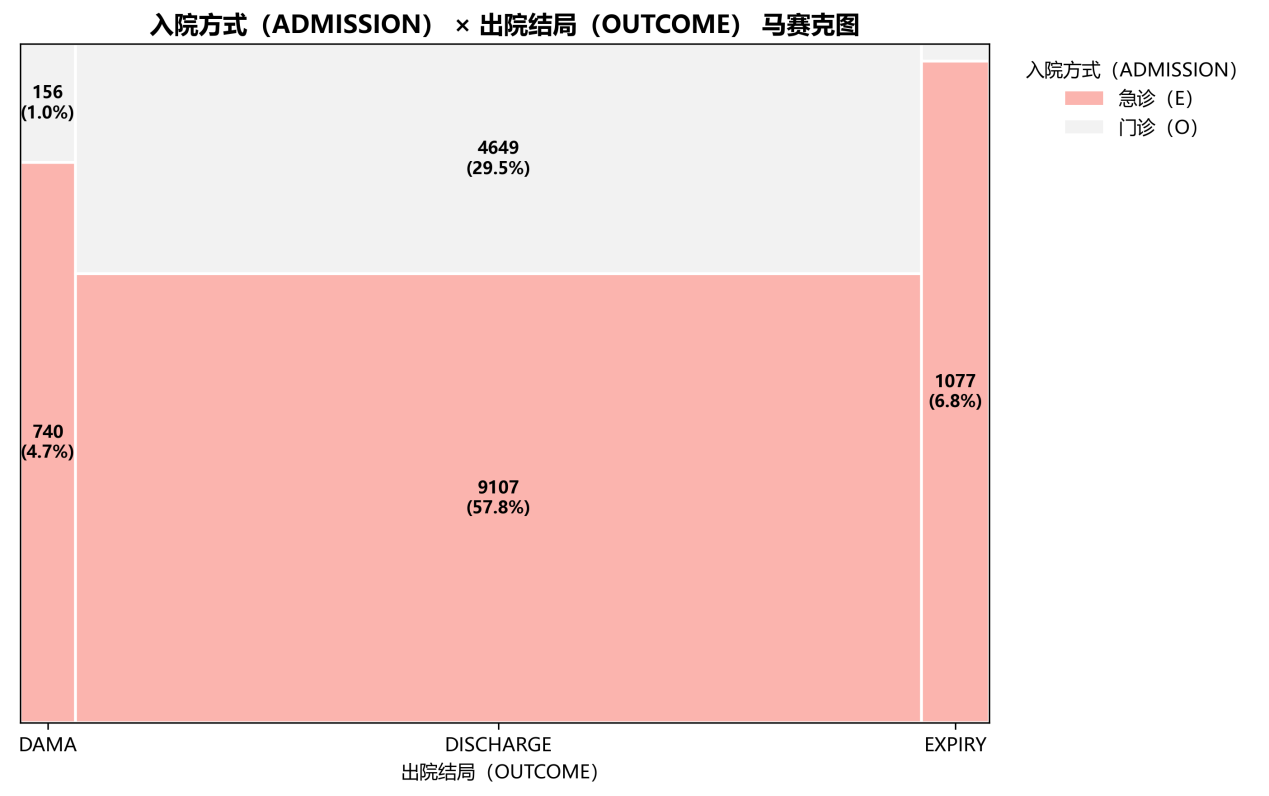
图13直观展示了入院方式与出院结局的联合分布差异,急诊入院死亡率显著高于门诊组,符合“急诊患者病情更重”的临床直觉,为急诊科加强危重患者识别与快速反应团队建设提供了量化依据。
三、多特征描述性分析:交互效应的挖掘
真实的临床场景往往错综复杂,两两变量的关联不足以涵盖疾病的全貌。通过进一步引入第三个或更多维度的变量,揭示隐藏在数据背后的复杂交互效应或立体特征,可为临床的精准分层与综合决策提供全局视野。
1.多维分组的分布差异
ICU停留时长是重症资源消耗的直接指标,分析其在不同入院方式与结局亚组间的差异,可为ICU床位预测与危重患者识别提供依据。
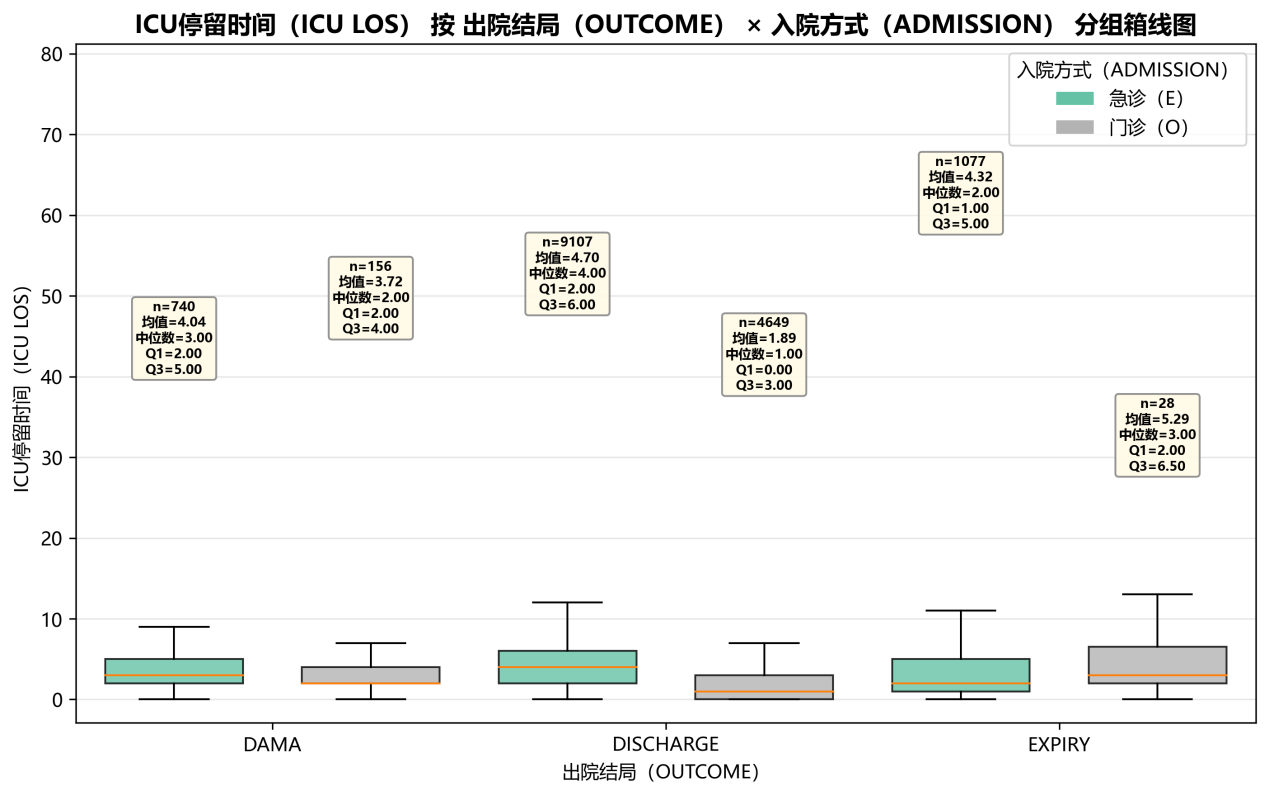
图14显示,急诊+死亡组(n=1077)均值4.32、中位数2、Q1=1、Q3=5,均值显著高于中位数且四分位距较宽,提示该组患者的病程轨迹呈现两极分化:一部分(约25%)在入院极短时间内(≤1天)即宣告抢救无效,而另一部分则经历了较长期(>5天)的ICU生命支持后才死亡。这种现象,反映出该群体具有高度的临床重症异质性。
门诊+死亡组虽然样本量极小(n=28),但均值高达5.29、中位数3、Q1=2、Q3=6.50,为全组最高,提示极少数经门诊入院但最终死亡的患者,其病情恶化迅速且ICU停留时间长。
急诊+出院组(n=9107)均值4.70、中位数4、Q1=2、Q3=6,说明经急诊入院的存活患者普遍面临较长的ICU停留。
门诊+出院组(n=4649)均值1.89、中位停留仅1天,且Q1=0,提示该群体多为轻症,其中至少25%的患者未产生实质性的ICU资源消耗(停留时间为0天)。
上述结果提示应当对急诊入院患者提前评估 ICU 需求,优化分级诊疗。
2.分层视角的效应修饰
旨在探究引入的第三变量(如出院结局)是否对原有两个变量(如性别与入院方式)的关联模式存在效应修饰(Effect Modification)。
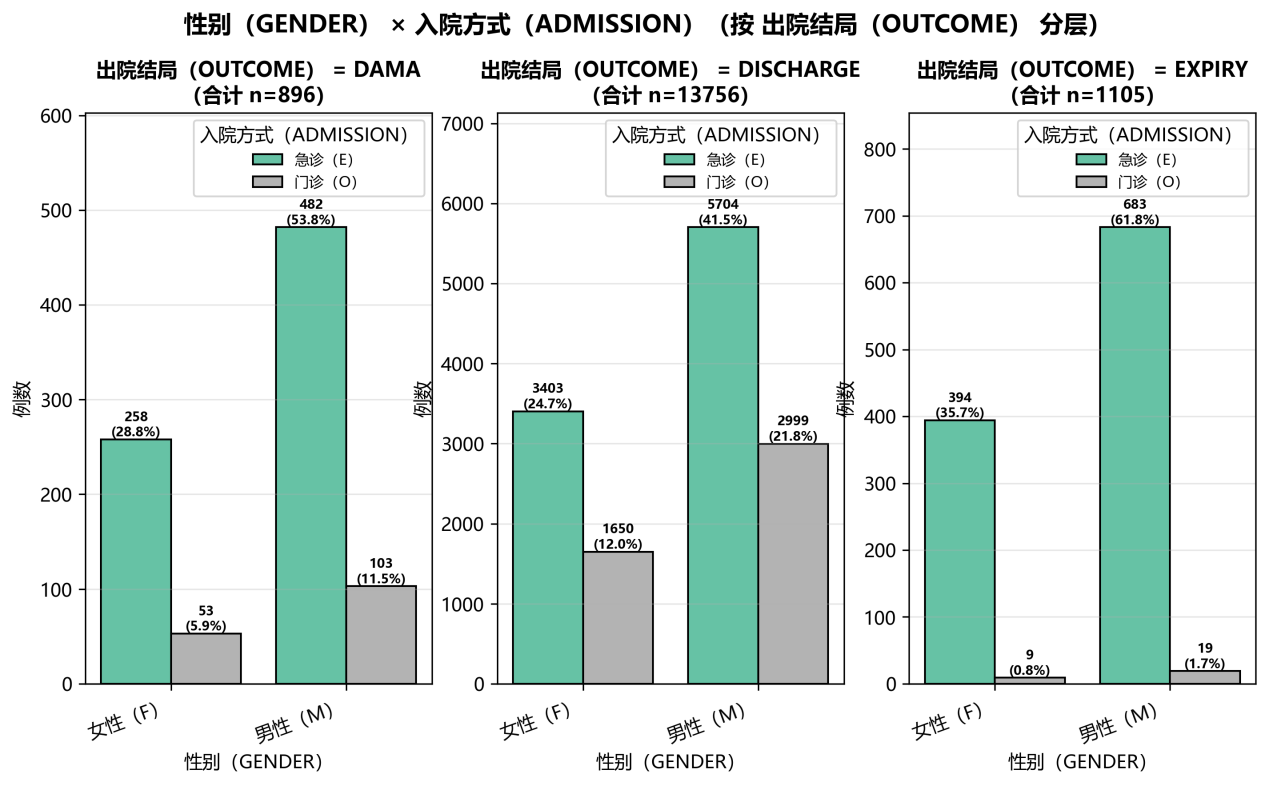
图15显示,在出院(DISCHARGE)分面中,男性急诊占41.5%,女性急诊24.7%;而在死亡(EXPIRY)分面中,男性急诊占比陡增至61.8%,女性急诊占比35.7%;而两性门诊入院后死亡的比例极低(男性1.7%,女性0.8%)。这种急诊构成比在死亡层中的大幅跃升,说明“结局”并非独立于上述变量之外,而是作为一个关键的交互效应修饰因子(Effect Modifier),显著放大了“男性”与“急诊入院”叠加时的致死风险。这提示临床针对男性急诊患者应给予更高等级的早期预警与干预措施。
四、系统界面设计与效果展示
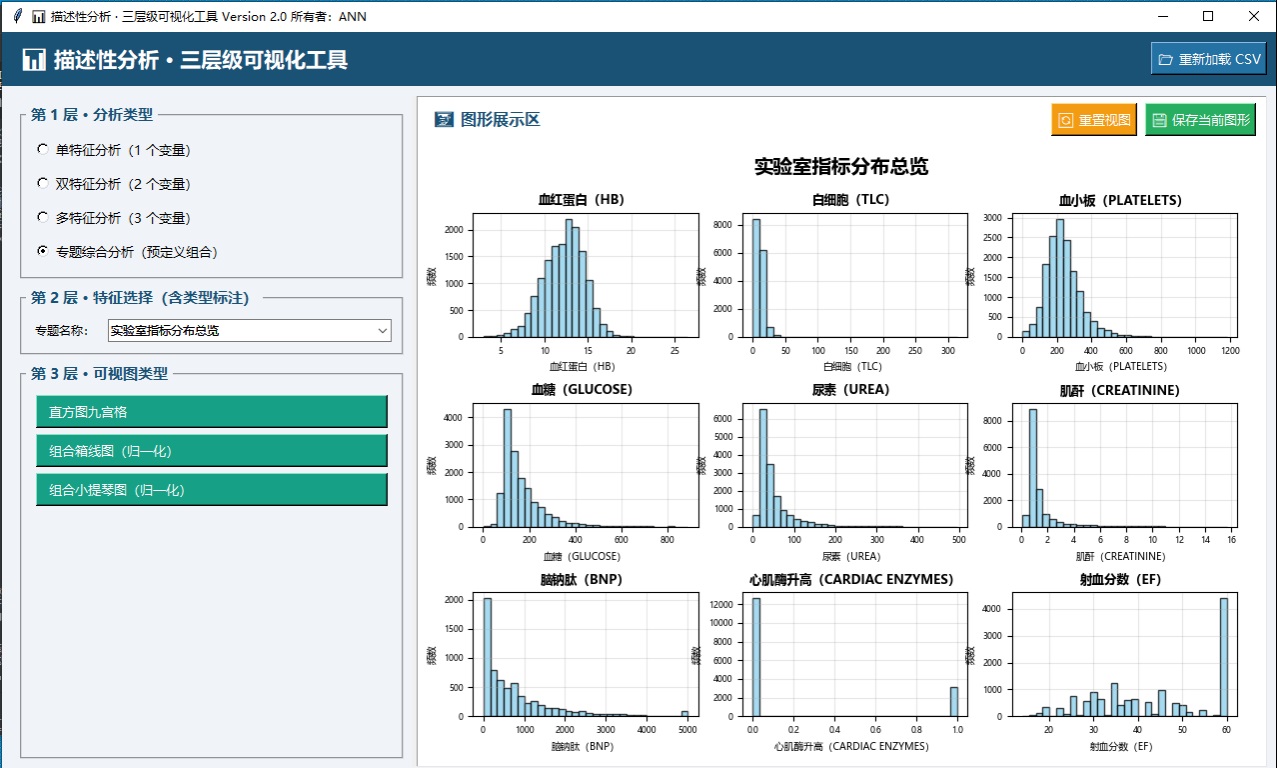
为直观呈现描述性分析的应用成效,笔者研究设计并开发了描述性分析可视化原型系统,采用三层级交互架构(如图16所示):依次进行分析类型选择、目标特征选取,并匹配相应的可视化图形进行展示。
五、结论
综上,描述性分析既是数据挖掘的起点,也是贯穿始终的“数据直觉”来源。当数据分析建立在扎实的描述性分析基础之上,推断性结论才能够具备可信度与可推广性。结合临床实践应用,描述性分析的意义可概括为以下四点:
第一,实现基线透明。使研究者与临床医生对人群特征形成共识,避免主观经验判断。
第二,推动风险可视。将抽象风险因素转化为可读的多维图形,便于多学科团队沟通。
第三,发挥假设生成。为后续构建回归模型、生存分析等提供变量筛选与交互项假设。
第四,强化决策支撑。从床位调度、专科配置到高危患者识别,提供量化的原始依据。
【往期回顾】
【作者简介】
安志萍,高级工程师,在职博士学历,专业技术上校退役。CHIMA委员,中国研究型医院学会医疗信息化分会理事,中国医疗保健国际交流促进会医学工程与信息学分会委员,中国医学装备协会医院物联网分会常务委员,《中国数字医学》杂志审稿专家。长期从事医院信息化建设工作。作者观点纯属与同行做技术交流,欢迎批评指正。

精彩不容错过!
我们将尽快与您联系!
【责任编辑:陈曦 版式:蒙辉】

评论前必须登录!
注册