 HIT专家网

来源:HIT专家网 作者:袁永福
在医疗AI的建设应用中,绝大多数医院没有能力自建算力,使用全国性的算力网是实现医疗行业普惠AI的重要途径。
全国算力网建设的特点之一是“东数西算”。假设原始数据来自上海,AI推理服务器部署在内蒙古乌兰察布。有两个数据推理任务,原始数据量分为1000GB和100GB,但两者包含的有效信息量一样,产生的结果也一样。经过笔者简单、不太严格的估算,1000GB的数据量网络传输时长800秒,耗电20度;100GB的时长80秒,耗电2度。
可以大体得出一个结论:“东数西算”的一条核心优化原则,是“数据瘦身”比“提高网速”值钱得多。如果我们在东部侧先做数据压缩、去重,只把有效信息传到西部,传输成本骤减,而推理结果不变。
以“数据瘦身”为出发点,结合医疗行业正在推进的OFD-H标准(《电子病历版式文档技术要求》),笔者在此提出一种思路:通过OFD-H内嵌Markdown文档的方式来实现“AI友好”。
OFD的特点
OFD很方便人工阅读,但不利于机器后台阅读,因此,单纯的OFD(没有“-H”的)文件在存储电子病历文档时存在其固有缺点。比如一段主诉文本为“主诉:水肿5年,反复加重2月”,在OFD中的content.xml就可能输出如图1所示。
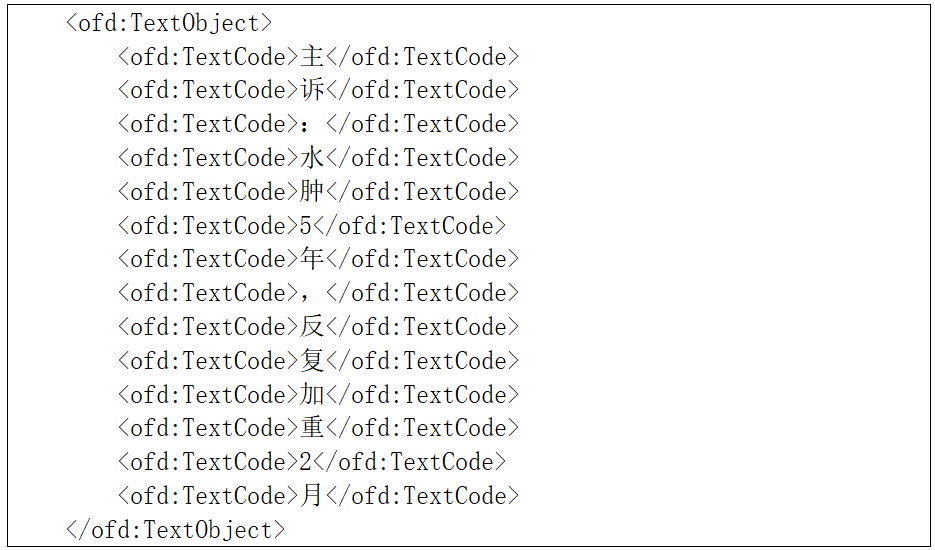
对于这样的OFD代码,软件很难可靠地还原出连续的文字,结构化字段区域的编号、数据类型等信息也丢失了。
另外,OFD采用多页内容分开处理的方式。当一段连续文本被分页拆开了,各个字符的存储位置在逻辑上非常遥远,进行大段文本的自动复原很困难,甚至不可能。
比如上例中的病历文本“现病史:患者于5年前劳动后发现小便中泡沫增多,时有浑浊,稍感身体疲乏,未予重视。”这段文本恰好跨页排版了,此时输出为OFD时可能变为两个片段:
文件[page1/content.xml]中的“<ofd:TextObject><ofd:TextCode>现病史:患者于5年前劳动后发现小便中泡沫增多,时有浑浊,稍</ofd:TextCode></ofd:TextObject><此处是一大段页脚内容的OFD代码>”。
文件[page2/content.xml]中的“<此处是一大段页眉内容的OFD代码><ofd:TextObject><ofd:TextCode>感身体疲乏,未予重视。</ofd:TextCode></ofd:TextObject>”。
实际上,这里的文本还由于两端对齐的原因,被拆成一个个字符,信息更为破碎。
对于这样的OFD文件,普通软件无法完整地识别文本内容。如果采用OCR、AI等技术,也只是稍微提高了识别概率,仍然是不可靠的,而且大幅增加了服务器工作量。
另外,在实践中我们还需要防范OFD的“可视化陷阱”,也就是OFD文档从软件处理的角度上是“所见非所得”,是“阳奉阴违”的。比如某个OFD文档打开后,如图2所示。
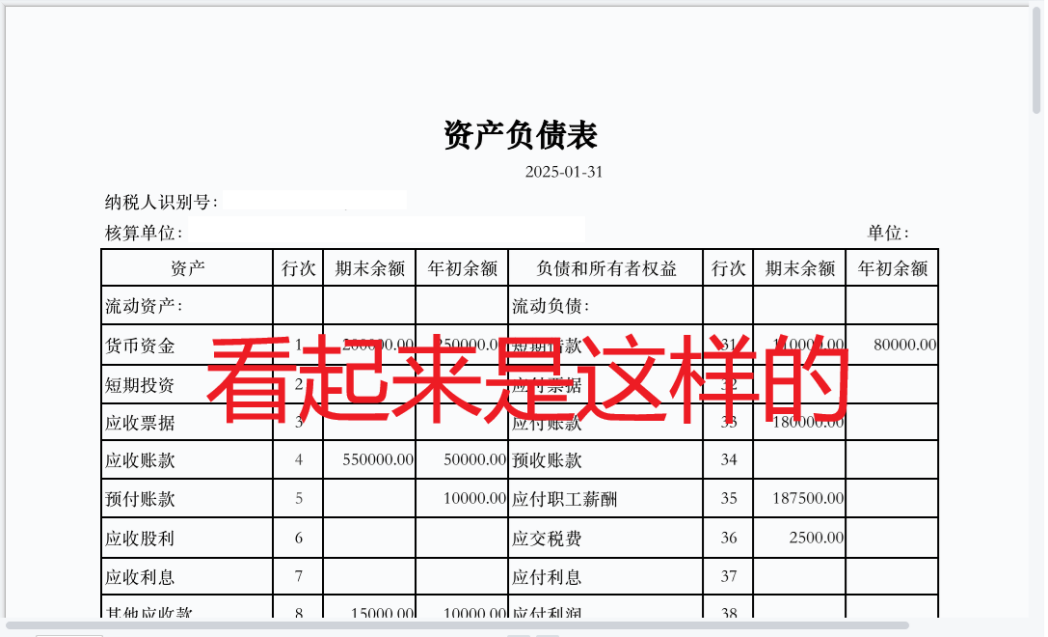
而打开OFD页面的content.xml内容,则如图3所示。
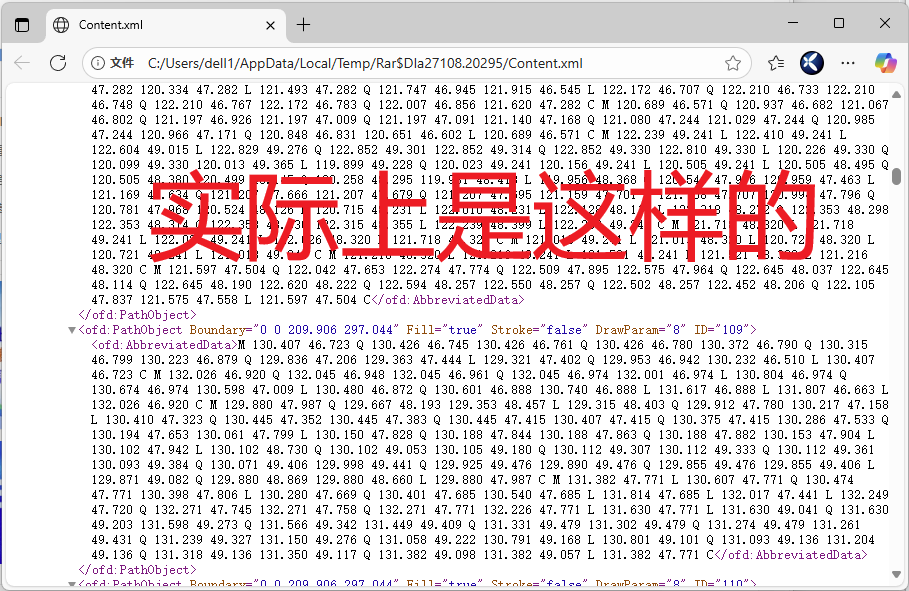
这是由于为了追求极致的跨平台阅读效果,OFD生成软件读取TTF文件,将字符轮廓数据输出为OFD路径,但不输出原始文本,这不符合OFD-H标准第7.2.b条款(“资源文件要求”)提出的“显示和打印所需的全部字型数据应包含在文件中”要求。软件自动从这种OFD文档中提取信息,非常困难。
我们还可以做个大致估算,假设有1000GB的OFD文件,处理前需要解压缩,释放出1500GB的content.xml文件,然后原样提供给KIMI3.0的AI服务器。此时可能消耗4000亿个词元,耗电30000度,费用600万元,耗时至少100小时。这个估算不是精确的,但数量级是差不多的。因为content.xml中大部分内容是版式信息、字符定位信息等,这些信息在大部分数据分析场景下是无效输入,纯粹浪费算力资源。
因此,对于后台AI分析而言,未经优化的OFD文件不是最佳数据格式,需要尽量避免。医院在采购OFD相关软件时,需执行OFD-H标准第9.2.e条款(“阅读软件”)、第7.5条款(“机读信息要求”)。而且,建议甲方亲自参与交叉验证。如果忽略这一点,那未来可能会付出代价。
Markdown简介
Markdown(简称MD)是一种轻量级标记语言,它是一种纯文本文档格式,不会做任何花哨的事情,比如改变字体大小、颜色或类型等,而是使用一种内嵌的纯文本指令定义粗体、多级大纲、表格等,还可以内嵌图片。比如对于图4所示的电子病历文档,其生成的带有YAML front matter标记头的MD文档内容如图5所示。
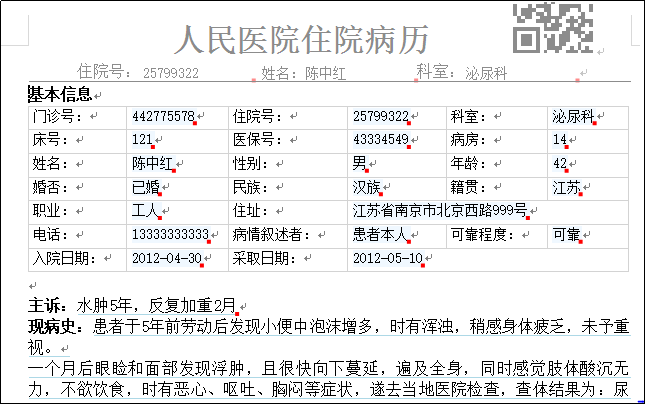
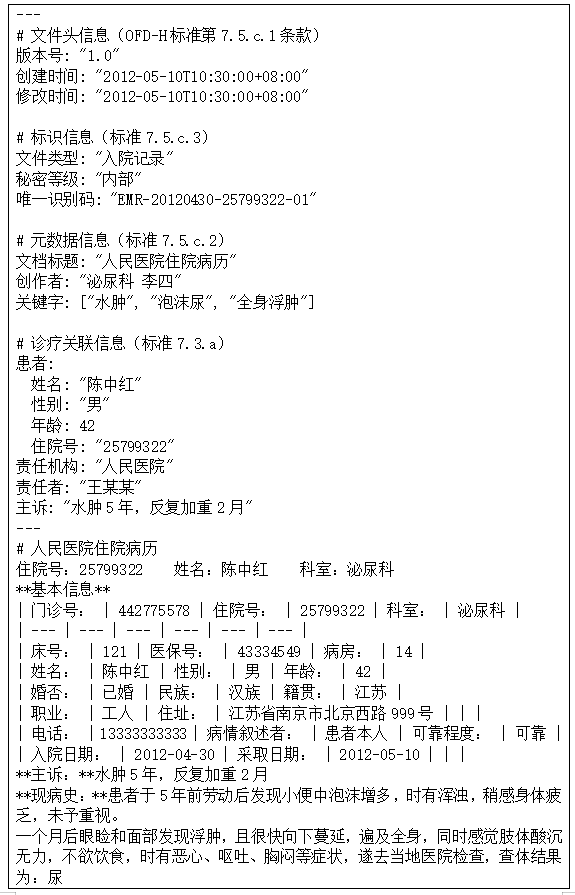
从这个例子来看,MD文件格式简洁明了,大量现有软件可快速展示并供人阅读,而且也方便机器后台分析,没有冗余信息。虽然MD文件无法定义精细的版式排版信息,不过在医院实际应用的大部分场景中,MD已足够用了。
OFD+MD
OFD和MD两种格式具有各自的优缺点,如果两者结合起来就能取长补短,达到1+1>2的效果。相比普通的OFD文件,OFD+MD的优势如下:
1.Token消耗更低:比如前面举例的1000GB的OFD文件,进行分析前只提取其中的MD文件,再发送给AI服务器,所消耗的词元数量骤降到十分之一,算力成本将从600万元降为60万元,耗时也大幅下降,而且产出还优于OFD格式。
2.传输效率更高:适配“东数西算”长距离、低带宽传输的核心需求。以30页病历文档为例,完整OFD文档大小约5-8MB,提取其中的MD纯文本仅需约50KB,大小不足完整OFD的1%;同时,轻量文本可大幅降低长距离传输时延,减少网络带宽占用,让东部医疗节点核心数据快速同步至西部算力枢纽,实现东西部数据与算力的高效协同,这也可响应OFD-H标准第5.3.2.a条款(“文档线性化”)。
3.场景适配更灵活:在远程医疗会诊、多终端数据视图查看等对版式要求低、需快速呈现文本的场景中,MD无需解析复杂版式数据,加载显示速度远快于传统OFD;OFD则可在归档、签章等合规场景发挥作用。
4.智能处理更高效:MD为AI提供干净直接的纯文本数据源,无需解析复杂XML或执行OCR识别,预处理工作量大幅降低,实现快速响应、批量处理。响应OFD-H标准第5.3.3条款(“检索查询”)。
5.数据流通更顺畅:标准化纯文本可无缝对接HIS、EMR、AI平台等医疗系统,打通数据壁垒,同时易于校验追溯。配合OFD的电子签名和时间戳可以实现MD子文件的防篡改、可审计,满足合规要求。响应OFD-H标准第8.c条款(“安全要求”)。
6.脱敏处理更安全:OFD-H标准第5.2.f条款(“应用框架”)要求,与其他医疗机构或医联体交换数据时,以脱敏处理后的版式文档为单元,不必把原始敏感信息整体带出机构。
MD V.S. JSON
MD作为纯文本格式,相比JSON等结构化格式,在大多数纯文本查看和处理场景中,具有很大的优势,主要包括:
MD具备天然的“可读性与轻量化双重优势”,其语法简洁直观,医护人员可直接阅读,无需依赖专业解析工具。而JSON作为结构化数据交换格式,存在大量括号、键值对等冗余标识,可读性差且文本冗余度高于MD,会增加Token消耗与传输负担。
另一方面,医疗病历以叙事性文本为主,非严格意义的结构化数据。MD的标题、列表、引用等轻量化格式,可适配病历的层级逻辑(如主诉、现病史、检查结果等),无需像JSON那样预设复杂的数据结构,能更灵活地适配不同类型病历的文本组织需求。
MD生态成熟,各类文本编辑器、AI模型均具备良好的兼容性,无需额外开发适配工具,降低落地门槛;而JSON在医疗文本的原生呈现与人工校验场景中,适配性远不及MD。
当然,JSON在结构化交换、校验、API、FHIR互操作方面有优势。因此,OFD+MD+JSON是“黄金搭档”。
落地实现
由于OFD-H标准中的“-H”并未明确约束其详细数据结构,具有一定的留白空间,OFD+MD可认为是对OFD-H标准第5.3.2.b条款(“传输交换”)、第7.5条款(“机读信息要求”)的一种有益探索。MD文件可以考虑存储在OFD文档中的Attachs子目录下(OFD-H标准第7.1.e条款“基本结构要求”)。
要实现OFD+MD,其最优化条件就是医院信息化系统具有“原生OFD能力”。这对医院信息系统开发组织(HIT厂商和自研医院)提出了一定的技术要求。
所谓原生OFD能力,就是医院信息系统能一步到位地将病历数据转换为OFD文件,还能根据OFD-H标准,将医疗健康相关数据合并到OFD文件中,生成OFD-H文件,包括生成描述病历内容的MD文件并追加到OFD文件中,OFD版面所含的文本信息也要和MD所含的信息确保一致(OFD-H标准第7.3.c条款“数据内容要求”)。也就是“病历数据+健康数据+MD→OFD-H”,这是“源头一步到位,福泽整个数据产业链”的发展路径。
但在当下,大量的开发组织没有原生OFD能力,只能借助OFD厂商提供的“PDF转OFD”的能力,采用的是“病历数据→PDF→OFD”的技术路径。此时生成的OFD文件只有版式信息,但缺乏“-H”的信息,更没有“+MD”的优势,还有大量数据无法追随OFD来传输。如果后面生成的OFD文件中的信息不足,系统需要进行原始数据追溯,但很多时候数据追溯又是无法实现的。这是在源头造成“技术欠账”,给整个数据产业链带来诸多不便。
另外,根据新的智慧医院评价标准,评价导向从“有数据”转向“反复利用数据”。如何才能反复利用数据?自然优先采用“源头一步到位的,福泽整个数据产业链”的路径。这就需要医院软件开发组织尽快掌握原生OFD能力。
我们南京都昌信息科技有限公司从事电子病历文档编辑器组件研发14年,在电子病历版式文档领域积累了深厚的技术和商业基础。在2024年5月28日,国家卫生健康委首次提出OFD时,我们迅速投入研发,当年就掌握了原生OFD能力。目前,我们正在将新发布的OFD-H标准落实到具体的软件功能中,并根据客户反馈不断增强其落地能力,积极响应OFD-H标准第9.1.a条款(“生成软件”)和第9.2条款(“阅读软件”)。
作为老牌的医疗软件组件供应商,我们正在赋能数百家HIT企业和数万家医院用户,使得医疗软件系统能以较低成本、更快速度来实现原生OFD-H功能,从而更好地满足新的国家标准和医院评级要求,并为AI的应用打下坚实基础。
(本文为个人观点,欢迎读者参与讨论。)

精彩不容错过!
我们将尽快与您联系!
【责任编辑:陈曦 版式:蒙辉】

评论前必须登录!
注册